为什么说Lakebase(湖库一体)开启了数据库新纪元?
几十年来,数据库一直是软件的基石,却也是技术栈中最不愿被触碰的那块"化石"。当应用架构、开发流程乃至代码的生产方式都被 AI 彻底改写时,底层数据库的架构却仍停留在 20 世纪 80 年代的假设之上。有没有可能让数据库通过新的能力跃迁,一站式满足AI时代的所有数据消费需求?Lakebase这种把事务型数据库"搬"到湖上的方式,或许是现代化数据架构的一种最 佳选择!
一个被忽视太久的"地基"
一个容易被忽略的事实:世界上的每一款软件、每一个应用程序、每一项工作流,乃至每一行 AI 生成的代码,最终都依赖于底层的数据库。但在这一过程中,我们彻底重构了应用程序的构建方式,底层数据库自 20 世纪 80 年代以来却鲜有改变。
这种"上层狂奔、底层停滞"的错位,正在三个维度上集中爆发:
运维脆弱且成本高昂:传统数据库被视为最脆弱的底层基础设施之一,需要一支庞大的专家团队"如履薄冰"地维护。计算与存储被捆绑在僵化的单体单元中,团队只能按峰值容量预配资源,大量昂贵资源长期闲置;而负载一旦超过预配容量,数据库可能直接失去响应。更棘手的是,像数据库快照或执行 GDPR 清理查询这样简单的维护任务,都有可能导致整个数据库宕机。
开发体验笨重:对代码而言,创建一个与代码库完全隔离的 git 开发分支只需不到一秒钟;但对数据库,预配环境可能需要数分钟甚至数小时,高保真克隆生产数据库成本极高,还有可能拖垮生产库。AI 驱动的开发模式进一步放大了这一矛盾——AI 代理需要即时启动临时、隔离的环境来进行实验。
极度的供应商锁定:单体架构意味着数据的进出只能通过数据库引擎本身,数据库迁移因此成为任何组织中最令人畏惧的技术项目之一。
在笔者看来,这三点并非孤立的技术债,而是同一个架构假设的三重投影:计算与存储不可分、数据格式不开放。只要这个假设不变,运维、开发体验和锁定问题就只能被缓解,无法被消除。
Lakebase 是什么?把"分离"概念推到逻辑终点!
从定义来看,Lakebase 是一种全新的开放架构,它将事务型数据库的最 佳特性与数据湖的灵活性和经济性结合在一起。其根本性的设计是——将计算与存储分离,将数据库数据以开放格式直接存放在低成本云存储("湖")中,同时允许事务计算层在上方独立运行。
其中,“分离”思维是这种设计的核心突破点。传统数据库将 CPU 和存储捆绑在一个单体系统中,必须作为一个大型机器进行预配、管理和付费;Lakebase 将这些层级拆开:数据开放地存在于湖中,数据库引擎则成为一个完全托管的无服务器(Serverless)计算层(例如 Postgres),能够即时弹性伸缩。
Lakebase的关键特性可以归纳为六点:
存算分离:数据以低成本存储在云对象存储中,计算独立且弹性运行。这实现了海量规模与高并发,并能在不到一秒内将资源缩减至零——这是传统数据库系统无法做到的,从而无需让昂贵的数据库机器闲置运行。
无限、低成本、高持久性的存储:数据存在于湖中,存储本质上无限且成本远低于需要固定容量基础设施的传统系统。其持久性由云对象存储(如 S3)提供支持,默认提供 99.999999999% 的数据持久性。文章特别指出,这优于传统数据库通过副本实现存储冗余的设定——副本通常是异步更新的,在发生双重故障的许多配置中存在数据丢失风险。
弹性、无服务器的 Postgres 计算:完全托管的无服务器 Postgres,可根据需求即时向上扩展、空闲时向下缩减,成本与使用量直接挂钩,适合突发型工作负载、开发环境以及启动临时实例的 AI 代理。
即时分支、克隆和恢复:数据库可以像开发者对代码进行分支操作一样进行分支和克隆。即使是 PB 级数据库也能在几秒内完成复制,从而实现快速实验、安全回滚和即时恢复,且无需额外的运维开销。
统一的事务与分析工作负载:Lakebase 与 Lakehouse(湖仓一体)无缝集成,在 OLTP 与 OLAP 之间共享同一个存储层,使得直接在事务数据上运行实时分析、机器学习和 AI 驱动的优化成为可能,无需移动或复制数据。
天生开放与多云支持:以开放格式存储的数据避免了专有格式锁定,实现跨 AWS、Azure 及更多平台的真正可移植性。内置的多云灵活性支持灾难恢复,带来长期的自由度与更优的经济效益。
另外,企业级事务系统还需要安全、治理、审计和高可用性等额外功能——但在 Lakebase 架构下,这些功能只需在一个统一的开放基础之上实现和管理一次。
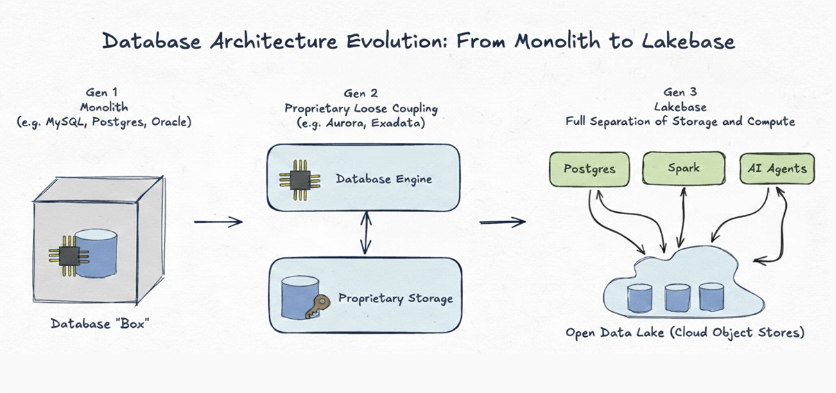
三代跃迁:一部架构"解耦"的进化史
要理解为什么现代化数据底座需要开启一个新纪元?我们有必要回顾一下过去五十年数据库架构的演进史,并将其划分为三个截然不同的世代。这个划分框架本身,就是全文最有价值的分析工具。
第一代:单体架构(Monolith)。
代表产品是 MySQL、Postgres以及经典的 Oracle架构。在云时代之前,网络是所有系统中最慢的部分,设计高性能数据库的唯一方法是将计算(CPU/内存)和存储(磁盘)紧密绑定在单台物理机内。这在 20 世纪 80 年代的硬件限制下是合理的,但它创造了一个僵化的牢笼:数据被困在专有格式中,扩展仅仅意味着购买更大的机器。
第二代:专有存储松耦合。
代表产品是 Aurora、Oracle Exadata。随着云基础设施改善,供应商在物理上将存储与计算分离,将存储移至专有的后端层。首先,我们必须承认这些系统是"工程奇迹",它将吞吐量推向了极限——但它们做得还不够彻底:这种分离纯粹是内部优化,数据仍被锁定在只有单一引擎才能访问的专有格式中,因而面临结构性的死胡同:
单引擎瓶颈:数据只能通过主数据库引擎访问,AI Agent或分析引擎很难大规模访问这些数据。
分析依然困难:无法让独立的 OLAP 引擎大规模直接访问数据库文件,运行分析查询依然困难,通常需要复杂的ETL 流程将数据移出。
云锁定:存储层通常与特定云供应商的专有基础设施紧密耦合,使多云互操作变得困难,真正的跨云高可用和灾难恢复(HADR)无从谈起。如果供应商的区域发生故障,数据就被困在那里。
综上来看,我们给出一个关键判断是:这些系统正处于向最终的第三代过渡的状态。
第三代:Lakebase——湖上的开放存储。
它与第二代一样将计算与存储分离,但有一个关键区别:存储基础设施和数据格式都是完全开放的。基于这种架构,前述三大挑战得以正面回应:
通过更简单的运维实现更高的可靠性和更低的成本:预配、扩缩容、分支、快照、恢复等常见操作可在数秒内完成;昂贵的查询可以在不同的弹性计算实例上运行,而不影响生产流量。
类 Git 的开发体验:基于生产数据库的高保真分支,让实验和开发应用变得更快。对开发者和 AI Agent而言,这意味着数据库的迭代速度能与代码一样快。
解决极度的供应商锁定:数据以开放格式存储在云对象存储中,锁定大幅减少——你拥有自己的数据,独立于引擎之外。
Lakebase不是一款新产品,而是一次架构范式的"清算"
抛开具体实现路径不说,我们分析这一战略方向的真正的意义在于,Lakebase为 "现代化数据库"的带来范本。
第一,它把"开放格式"提升为架构原则,而非兼容性选项。 第二代系统已经完成了物理上的存算分离,但因为数据格式仍是专有的,分离带来的收益被单引擎瓶颈、ETL问题和云锁定抵消了大半。Lakebase 的论点本质上是:解耦如果不彻底到数据格式层面,就只是把单体从一台机器搬进了一个供应商的后院。 这个判断对当前市场上大量"云原生数据库"同样成立。
第二,它把 AI Agent当作一等公民负载来设计。 这也是所谓的"即时启动临时、隔离的环境""不到一秒缩减至零""按实际使用量付费"——这些不是传统 OLTP 的典型诉求,而是Agent驱动工作负载的刚需。换句话说,Lakebase 的架构选择不是为既有负载做优化,而是为一种尚未完全成型的工作负载预先铺路。这是一种有风险但方向清晰的押注。
第三,它把数据库的竞争维度从"性能"部分转向"迭代速度"。 "数据库的迭代速度能与代码一样快"这句话,实际上是在用软件工程的成熟度标准来要求数据库。当分支、克隆、恢复都变成秒级操作,数据库才真正进入现代敏捷开发与 CI/CD 的节奏。
当然,我们对 Lakebase 的了解不应该只停留在架构层面:企业级场景所需的安全、治理、审计与高可用性等这些"额外功能"也同样重要。多云可移植性的实际表现、开放格式下事务性能与延迟的量化对比,这些问题都值得深入研究。这些也都是Lakebase架构从"理念成立"走向"生产可信"必须要解决的问题。
结语
Lakebase走上时代前沿,是因为它存在诸多优势,比如:廉价、可靠的对象存储和云弹性可用。换句话理解,Lakebase 就是我们今天重新设计 OLTP 数据库时就应该有的样子。相信,随着企业云和 AI 融合发展步伐的加速,Lakebase这种模式将成为构建事务型系统的标准。